无需账号的 PDF OCR
上传扫描 PDF 或图片,在首页直接提取纯文本。

当扫描 PDF、截图、票据或图片里 Ctrl+F 搜不到、文字也无法复制时,直接上传文件。提取文字后可复制或下载结果,无需创建账号。
复制 OCR 输出,或下载为 TXT 文件。
第一版保持技术栈简洁:Cloudflare 静态部署、PDF 渲染,以及单页 OCR 工作流。

上传扫描 PDF 或图片,在首页直接提取纯文本。
上传文件、选择语言,然后绕过账号门槛直接提取文字。
通过 Tesseract 语言包支持英文、中文、日文、韩文和主要欧洲语言。
一个上传流程支持 PDF 页面、截图、拍照扫描和常见图片格式。
复制提取文字,或下载 TXT,用于搜索、翻译、总结或归档。
围绕 Unlimited OCR 和 PDF OCR 工作流设计,后续可接入更强的文档 AI。
这些是用户寻找 PDF OCR 工具前真实会搜索的问题。

扫描版 PDF 看起来像文档,但页面本质上是图片。PDF OCR 会提取可搜索文本,让搜索重新可用。
上传扫描件、票据、截图或拍照图片,把可见文字转换成可复制的纯文本。
先用 OCR 输出文本,再把 PDF 分块,用于 RAG、语义搜索、笔记或总结。
DeepSeek-OCR、Baidu Unlimited-OCR 等研究模型说明长文档解析还会继续增强。本站从无需登录的 OCR 工具开始,后续保留接入模型解析的空间。
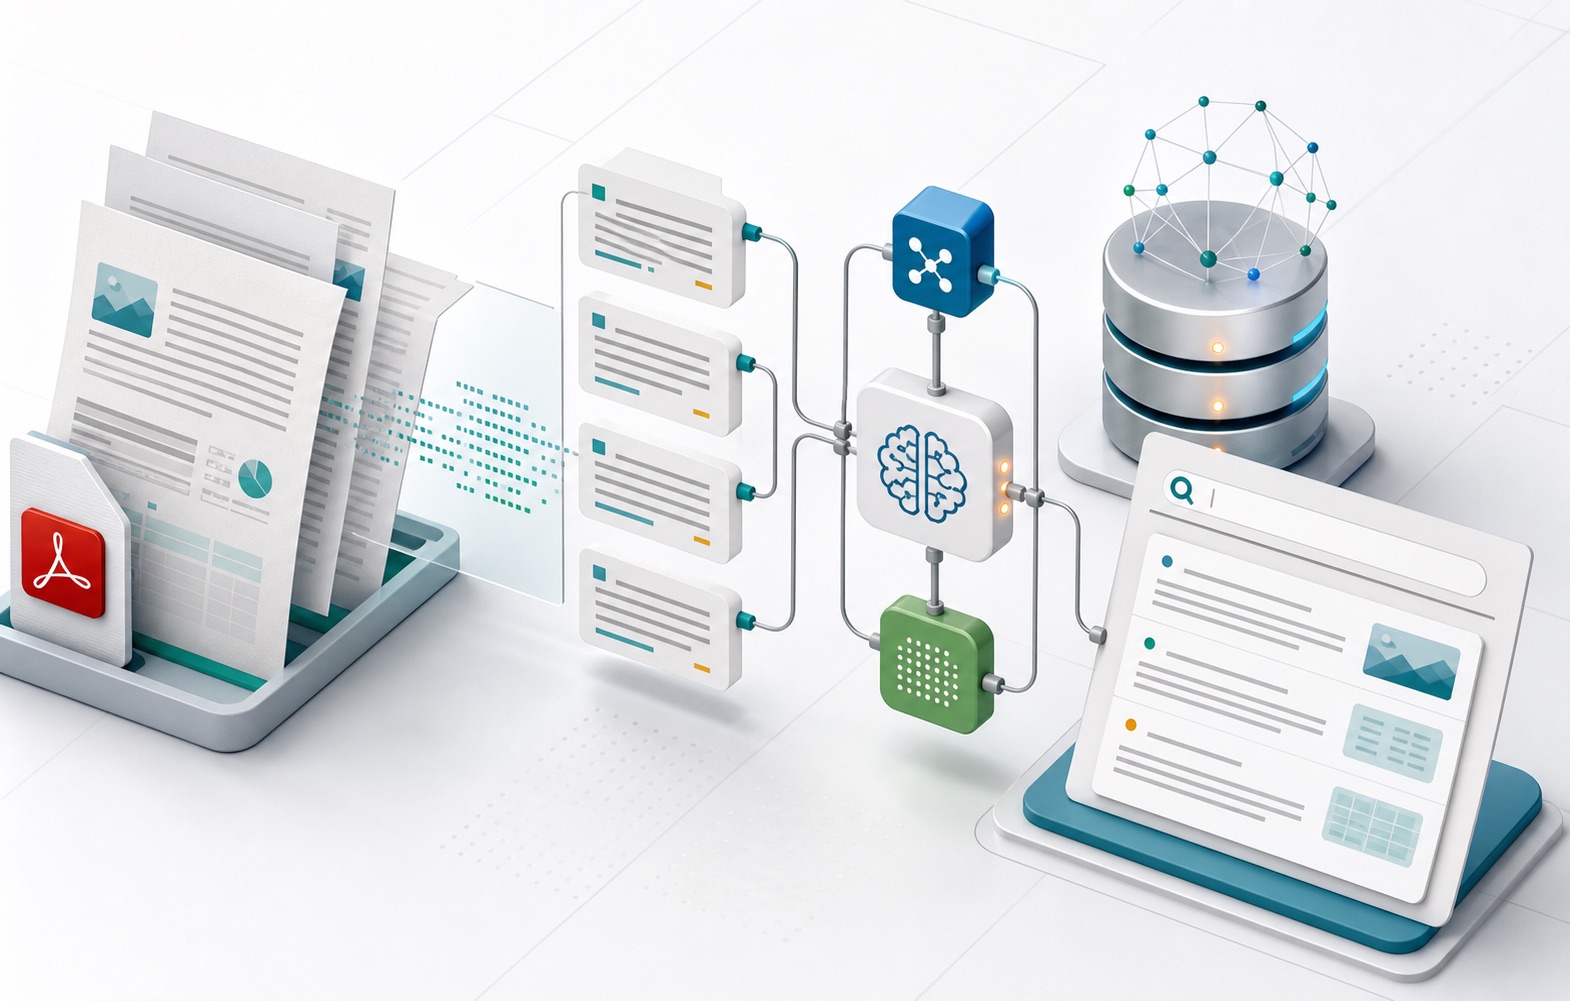
PDF.js 会把每一页渲染出来用于识别。Tesseract.js 读取渲染后的页面,应用再按页码顺序合并结果。这个方案朴素、部署便宜,对公开的无需登录版本足够实用。
第一版故意保持朴素:快速上传、OCR 处理、可用的文字输出。
| 需求 | 常见免费 OCR | Unlimited OCR |
|---|---|---|
| 需要账号 | 通常需要 | OCR 工具无需登录 |
| PDF 处理 | 可能要求上传到服务器 | PDF 页面会被准备为可识别图像 |
| 最适合 | 一次性简单文件 | 扫描 PDF、截图、笔记、票据 |
| 输出 | 纯文本或受限预览 | 可复制文本和 TXT 下载 |
无需登录的 OCR 工具是上线起点。等准确率、表格或长文档需求值得投入额外基础设施时,可以再接入模型解析。
| 引擎 | 作用 | 为什么重要 |
|---|---|---|
| Tesseract.js | 图片 OCR 引擎 | 隐私成本低、部署便宜,适合公开的无需登录 OCR |
| PDF.js | PDF 页面渲染 | 把扫描 PDF 页面转换成 canvas 图像 |
| Baidu Unlimited-OCR | 未来的模型解析 | 当具备 GPU 后端时,更适合长文档解析 |
为常见图片 OCR、PDF OCR 和 AI OCR 工作流准备的描述性内链。
关于当前 Unlimited OCR 上线版本的简明回答。
第一版一次处理一个 PDF 或图片,避免让浏览器负载过高。如果用户需要,后续可以加入批量 OCR。
通常是的。如果搜索找不到页面上能看到的文字,这个 PDF 很可能是扫描件或纯图片文档。
可以。TXT 输出是 RAG 入库、语义搜索、总结或翻译流程的简单第一步。
第一版提取纯文本。表格重建、字段提取和可搜索 PDF 输出应在确实需要时再加入。